В апреле 2017 года Штефан Кох описал NewCTFE — эксперимент по замене механизма вычисления функций во время компиляции в D. Приведённые сроки, ограничения старого интерпретатора и планы относятся к тому этапу проекта. Это рассказ об архитектуре компилятора, а не сообщение о состоянии сегодняшнего DMD.
Зачем выполнять функцию при компиляции
CTFE означает Compile-Time Function Execution. Компилятор вычисляет допустимое выражение заранее, когда значение требуется во время компиляции. Такой подход позволяет получить константную таблицу обычным понятным кодом вместо вручную выписанного массива чисел.
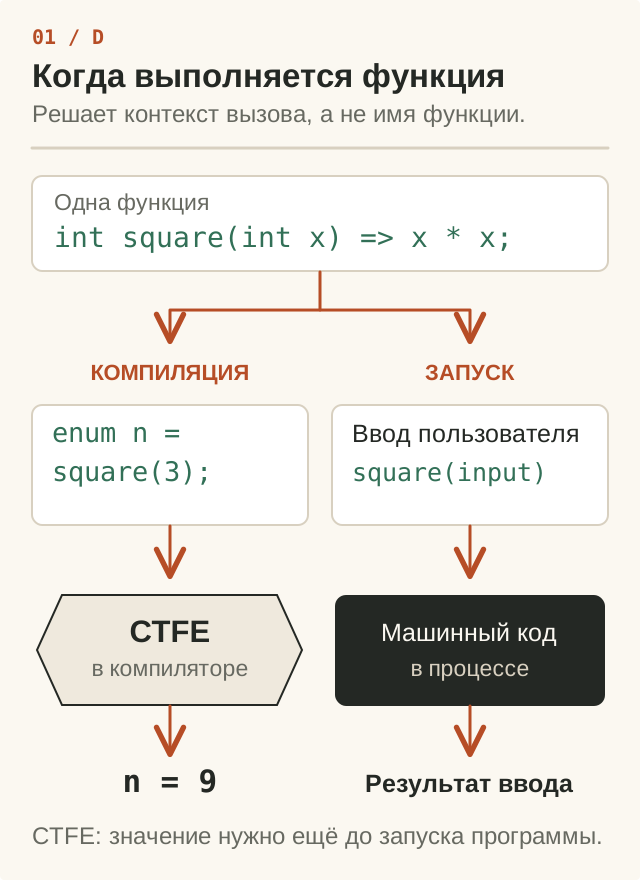
Доступные во время компиляции аргументы необходимы, но сами по себе ещё не обещают, что произвольная функция будет вычислена через CTFE. Вычисление должно укладываться в ограничения интерпретатора языка. Атрибут pure и возможность CTFE — не одно и то же условие. Точные ограничения перечислены в спецификации D.
Пример таблицы классификации URI
В исходной статье использовалась таблица для ASCII-символов URI. Ниже — её идея с сохранёнными именами флагов. Это фрагмент модуля, где URI_Hash, URI_Alpha и остальные маски уже определены, а не отдельная программа:
private immutable ubyte[128] uri_flags = (() {
    ubyte[128] flags;
    flags['#'] |= URI_Hash;
    foreach (c; 'A' .. 'Z' + 1) {
        flags[c] |= URI_Alpha;
        flags[c + 0x20] |= URI_Alpha;
    }
    foreach (c; '0' .. '9' + 1) flags[c] |= URI_Digit;
    foreach (c; ";/?:@&=+$,") flags[c] |= URI_Reserved;
    foreach (c; "-_.!~*'()") flags[c] |= URI_Mark;
    return flags;
})();
Анонимная функция создаёт локальный массив, помечает классы символов и возвращает результат. Вызов () после литерала сразу вычисляет эту функцию. Для инициализации такой переменной уровня модуля значение должно быть получено при компиляции. Мы не платим за построение таблицы при каждом запуске приложения.
По сравнению с набором «магических чисел» такой исходник объясняет назначение каждой группы. Дополнительное обсуждение областей времени компиляции есть в D Wiki.
Почему старый интерпретатор расходовал память
У более сложных задач цена вычислений становится заметной. В статье в качестве примера упоминались регулярные выражения: построение специализированного автомата для сложного паттерна могло сильно увеличить время компиляции и расход памяти. Это исторические наблюдения о конкретной реализации, а не универсальная оценка любого современного паттерна.
Тогдашний интерпретатор обходил AST — абстрактное синтаксическое дерево. Для представления результатов вычисления использовались узлы классов DMD. Частые операции в цикле могли создавать огромное количество временных узлов, хотя программе нужен только конечный результат. Так внутреннее представление исходника превращалось в дорогую структуру данных для выполнения.
Кох ссылался на issue 12844 со значительным потреблением памяти при обработке шаблона std.regex и issue 6498 с большим циклом CTFE. Эти записи нужны как свидетельства исходной проблемы. Сравнивать по ним текущие версии без повторного измерения нельзя.
Просто освобождать каждый временный узел сразу неудобно: нужно знать, кто ещё на него ссылается, и не превратить интерпретацию в постоянные обходы сборщика мусора. Иными словами, проблема была не только в количестве памяти, но и в выборе представления выполняемой программы.
Идея NewCTFE: отдельный байт-код
Вместо непосредственного выполнения AST можно сначала преобразовать функцию в компактный набор виртуальных инструкций, а затем исполнять его специализированным интерпретатором. У виртуальной ISA — архитектуры набора команд — нет обязанности повторять физический процессор. Её удобно проектировать под нужды вычислений компилятора.
Это не делает проект автоматически JIT-компилятором. Интерпретация байт-кода и генерация машинного кода во время выполнения — разные варианты реализации. Переход к JIT потребовал бы отдельного механизма перевода в инструкции хоста.
В исходном рассказе Кох подчёркивал различие между написанием самого исполнителя инструкций и подготовкой этих инструкций из языка D. Первые простые примеры появились сравнительно быстро, но поддержка более сложных конструкций требовала существенно большей работы. Полнота семантики, а не только скорость внутреннего цикла, определяет пригодность такого движка.
Что сравнивать в двух подходах
| Вопрос | Выполнение AST | Отдельный байт-код |
|---|---|---|
| Представление программы | Структуры синтаксического дерева компилятора | Инструкции для специализированной виртуальной машины |
| Цена подготовки | Можно использовать существующее дерево | Нужен дополнительный этап генерации инструкций |
| Временные значения | Зависят от устройства узлов и интерпретатора | Можно спроектировать отдельное компактное хранение |
| Главная сложность | Не сделать обход и создание узлов слишком дорогими | Сохранить семантику всех поддерживаемых конструкций |
Таблица объясняет архитектурный выбор, а не заменяет измерение производительности. Для честного сравнения нужен один и тот же исходник, одинаковый результат вычисления, версия компилятора и измерения времени и максимальной памяти.
Исторический контекст и автор
На момент публикации автор готовился к выступлению на DConf 2017 и рассматривал NewCTFE как продолжающуюся работу. Планы по версии 1.0 нельзя читать как подтверждение её последующего выпуска. Для оценки проекта полезно отдельно рассматривать представление программы, генерацию инструкций, выполнение и полноту семантики.
Материал основан на переводе статьи Штефана Коха The New CTFE Engine. В исходной биографической справке он упоминался как разработчик sqlite-d и участник проектов SDC и vibe.d.